Domain vormacht.de kaufen?
Wir ziehen mit dem Projekt
vormacht.de um.
Sind Sie am Kauf der Domain
vormacht.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain vormacht.de kaufen?
Was bedeutet Vorherrschaft/Hegemonie?
Vorherrschaft oder Hegemonie bezeichnet die dominante Stellung oder Kontrolle einer Gruppe, Nation oder Organisation über andere. Es beinhaltet die Fähigkeit, Entscheidungen zu treffen und Einfluss auszuüben, um die eigenen Interessen durchzusetzen und andere Akteure zu beeinflussen. Hegemonie kann auf politischer, wirtschaftlicher oder kultureller Ebene stattfinden. **
Was macht ein Data Scientist?
Ein Data Scientist ist für die Analyse großer Mengen von Daten verantwortlich, um wertvolle Erkenntnisse und Muster zu identifizieren. Sie entwickeln und implementieren Algorithmen und Modelle, um Prognosen und Trends vorherzusagen. Data Scientists verwenden verschiedene Programmiersprachen und Tools, um Daten zu sammeln, zu bereinigen und zu visualisieren. Sie arbeiten eng mit anderen Teams zusammen, um datengesteuerte Entscheidungen zu treffen und Geschäftsziele zu erreichen. Insgesamt ist ein Data Scientist dafür verantwortlich, Daten in verwertbare Informationen umzuwandeln und so einen Mehrwert für das Unternehmen zu schaffen. **
Ähnliche Suchbegriffe für Open Data
Top-Angebote
Produkte zum Begriff Open Data:
-
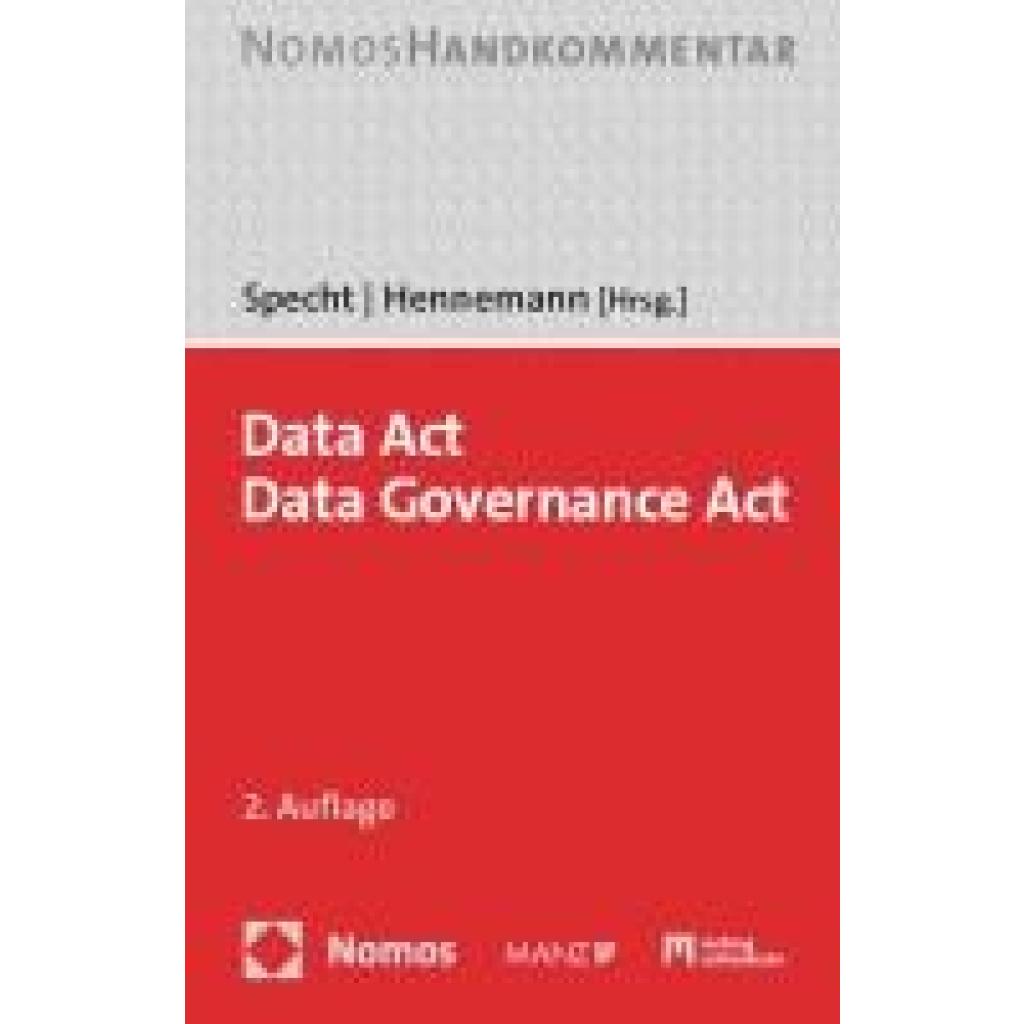
Data Act. Data Governance Act: DA, DGAData Act. Data Governance Act: DA, DGA , Handkommentar , Offroad-Leuchten > Zusatzbeleuchtung , Auflage: 2. Auflage, Erscheinungsjahr: 202412, Produktform: Leinen, Redaktion: Specht, Louisa~Hennemann, Moritz, Edition: NED, Auflage: 24002, Auflage/Ausgabe: 2. Auflage, Seitenzahl/Blattzahl: 1500, Keyword: Anonymisierung; DGA; DS-GVO; Datenaltruismus; Datenintermediäre; Datenrecht; Datenspenden; Datentreuhänder; Europäisches Datenrecht; Europäisches Wirtschaftsrecht; Geschäftsgeheimnisse; Weiterverwendung von Daten; Öffentliche Stellen, Fachschema: Datenschutzrecht~Europa / Europäische Union~Europäische Union - EU~Europarecht~Internationales Recht / Europarecht~International (Recht)~Internationales Recht~Menschenrechte~Jurisprudenz~Recht / Rechtswissenschaft~Rechtswissenschaft~Copyright~Geistiges Eigentum~Urheberrecht - Urheberrechtsgesetz - UrhG~Verfassungsrecht, Fachkategorie: Internationales Recht: Gewerblicher Rechtsschutz und Urheberrecht~Datenschutzrecht, Region: Deutschland~EU, Europäische Union, Warengruppe: HC/Internationales und ausländ. Recht, Fachkategorie: Schutz der Privatsphäre, Datenschutzrecht, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Nomos Verlags GmbH, Verlag: Nomos Verlags GmbH, Produktverfügbarkeit: 02, Blätteranzahl: 1456 Blätter, Länge: 207, Breite: 133, Höhe: 67, Gewicht: 1318, Produktform: Gebunden, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft,179,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Complete Guide to Open Source Big Data Stack, Fachbücher von Michael FramptonSehen Sie, wie ein auf Mesos basierender Big-Data-Stack erstellt wird und welche Komponenten verwendet werden. Sie werden derzeit verfügbare Apache-Systeme, sowohl vollständige als auch in der Inkubation befindliche, nutzen. Die Komponenten werden anhand von Beispielen vorgestellt, und Sie lernen, wie sie zusammenarbeiten. Im vollständigen Leitfaden zum Open-Source-Big-Data-Stack beginnt der Autor mit der Erstellung einer privaten Cloud und installiert und untersucht dann Apache Brooklyn. Anschliessend verwendet er jedes Kapitel, um ein Stück des Big-Data-Stacks vorzustellen, und teilt mit, wie man die Software beschafft und installiert. Sie lernen Schritt für Schritt und Kapitel für Kapitel anhand einfacher Beispiele, während ein echter Big-Data-Stack erstellt wird. Das Buch konzentriert sich auf Apache-basierte Systeme und bietet detaillierte Beispiele für Cloud-Speicher, Release-Management, Ressourcenmanagement, Verarbeitung, Warteschlangen, Frameworks, Datenvisualisierung und mehr. Was Sie lernen werden: - Installieren Sie eine private Cloud auf dem lokalen Cluster mit Apache Cloud Stack - Beschaffen, installieren und konfigurieren Sie Apache: Brooklyn, Mesos, Kafka und Zeppelin - Sehen Sie, wie Brooklyn verwendet werden kann, um Mule ESB in einem Cluster und Cassandra in der Cloud zu installieren - Installieren und verwenden Sie DCOS für die Big-Data-Verarbeitung - Verwenden Sie Apache Spark für die Datenverarbeitung im Big-Data-Stack Für wen dieses Buch gedacht ist: Entwickler, Architekten, IT-Projektmanager, Datenbankadministratoren und andere, die mit der Entwicklung oder Unterstützung eines Big-Data-Systems beauftragt sind. Es richtet sich auch an alle, die an Hadoop oder Big Data interessiert sind, sowie an diejenigen, die Probleme mit der Datengrösse haben.48,14 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was macht ein Data Analyst?
Ein Data Analyst sammelt, analysiert und interpretiert große Mengen von Daten, um Einblicke und Trends zu identifizieren. Sie verwenden statistische Methoden und Software, um Muster in den Daten zu erkennen und Geschäftsentscheidungen zu unterstützen. Data Analysts erstellen Berichte, Dashboards und Visualisierungen, um komplexe Informationen verständlich darzustellen. Sie arbeiten eng mit anderen Teams zusammen, um Daten zu verstehen und Empfehlungen für Verbesserungen oder Optimierungen zu geben. Insgesamt helfen Data Analysts dabei, datengesteuerte Entscheidungen zu treffen und das Geschäftswachstum voranzutreiben. **
-
Was macht ein Big Data Analyst?
Was macht ein Big Data Analyst? Ein Big Data Analyst sammelt, analysiert und interpretiert große Mengen von Daten, um wertvolle Einblicke und Muster zu gewinnen. Sie verwenden spezielle Software und Tools, um komplexe Datenmodelle zu erstellen und Trends zu identifizieren. Darüber hinaus helfen sie Unternehmen, fundierte Entscheidungen zu treffen, indem sie Prognosen und Empfehlungen auf der Grundlage ihrer Analysen bereitstellen. Ein Big Data Analyst arbeitet eng mit verschiedenen Teams zusammen, um Datenquellen zu identifizieren, Daten zu bereinigen und zu organisieren und letztendlich datengesteuerte Lösungen zu entwickeln. **
-
Was bedeuten Data Science und Data Engineering?
Data Science bezieht sich auf die Analyse und Interpretation von Daten, um Erkenntnisse und Muster zu gewinnen, die bei der Lösung von Problemen und der Unterstützung von Entscheidungsprozessen helfen. Data Engineering hingegen bezieht sich auf die Entwicklung und Verwaltung von Dateninfrastrukturen, um sicherzustellen, dass Daten effizient erfasst, gespeichert, verarbeitet und analysiert werden können. Data Engineering legt den Fokus auf die technische Seite der Datenverarbeitung, während Data Science sich auf die Analyse und Interpretation der Daten konzentriert. **
-
Was macht ein Business Intelligence Data Architect?
Ein Business Intelligence Data Architect ist für die Gestaltung und Verwaltung von Datenarchitekturen in einem Unternehmen verantwortlich. Sie analysieren die Datenbedürfnisse der Organisation, entwerfen Datenmodelle und Datenbanken, implementieren Datenintegrationsprozesse und stellen sicher, dass die Datenqualität und -integrität gewährleistet sind. Sie arbeiten eng mit anderen Fachbereichen zusammen, um sicherzustellen, dass die Dateninfrastruktur den Geschäftsanforderungen entspricht. **

Was sind die grundlegenden Funktionen von SPARQL und wie kann es zur Abfrage und Abfrage von verknüpften Open Data verwendet werden?
SPARQL ist eine Abfragesprache für RDF-Daten, die es ermöglicht, komplexe Abfragen über verknüpfte Datenquellen auszuführen. Die grundlegenden Funktionen von SPARQL umfassen das Abfragen von Daten, das Filtern von Ergebnissen und das Verknüpfen von verschiedenen Datenquellen. Durch die Verwendung von SPARQL können Benutzer Daten aus verschiedenen Quellen abrufen und miteinander verknüpfen, um neue Erkenntnisse zu gewinnen. **
Sind "data" und "data" beim USB-Kabel TX und RX?
Nein, "data" und "data" beziehen sich nicht auf die TX (Transmit) und RX (Receive) Pins beim USB-Kabel. Beim USB-Kabel gibt es vier Pins: VCC (Stromversorgung), GND (Masse), D+ (Datenleitung) und D- (Datenleitung). Die TX- und RX-Pins werden normalerweise bei seriellen Kommunikationsschnittstellen wie UART verwendet. **
Top-Angebote
Produkte zum Begriff Open Data:
-
Kaspersky Threat Data Feeds - Open Source ThreatsKaspersky Threat Data Feeds – Open Source Threats In einer Zeit, in der Cyberbedrohungen komplexer und zielgerichteter denn je sind, ist eine umfassende Bedrohungsüberwachung unerlässlich. **Kaspersky Threat Data Feeds - Open Source Threats** stellt eine innovative Lösung dar, die Sicherheitsverantwortlichen aktuelle und relevante Informationen zu Bedrohungen bietet, die aus Open-Source-Quellen stammen. Diese Bedrohungsfeeds ermöglichen es Unternehmen, sich kontinuierlich über die neuesten Bedrohungen aus dem Open-Source-Bereich zu informieren und ihre Sicherheitsmaßnahmen entsprechend anzupassen. Mit Kaspersky Threat Data Feeds - Open Source Threats können Unternehmen proaktiv auf Bedrohungen reagieren und so ihre Widerstandsfähigkeit gegenüber Cyberangriffen deutlich verbessern. Überblick über Kaspersky Threat Data Feeds - Open Source Threats Die Lösung **Kaspersky Threat Data Feeds - Open Source Threats** bietet Unternehmen Zugang zu einer Fülle an Bedrohungsdaten, die speziell aus Open-Source-Quellen gesammelt werden. Diese Feeds bieten detaillierte Informationen über aktuelle Bedrohungen und ermöglichen eine proaktive Abwehr. Durch die kontinuierliche Analyse und Filterung relevanter Daten aus öffentlich zugänglichen Quellen hilft Kaspersky Unternehmen dabei, potenzielle Gefahren frühzeitig zu erkennen und geeignete Schutzmaßnahmen zu implementieren. Hauptfunktionen Echtzeit-Updates zu Open-Source-Bedrohungen: Regelmäßige Aktualisierungen, die es Unternehmen ermöglichen, stets über die neuesten Bedrohungen informiert zu sein. Umfassende Bedrohungsanalyse: Detaillierte Informationen zu Bedrohungen, die aus Open-Source-Quellen stammen und für die Cybersicherheit von Bedeutung sind. Integration in bestehende Sicherheitslösungen: Kaspersky Threat Data Feeds lassen sich problemlos in vorhandene Sicherheitssysteme integrieren, um einen ganzheitlichen Schutz zu gewährleisten. Unterstützung für maschinenlesbare Formate: Die Bedrohungsdaten werden in Formaten wie STIX und TAXII bereitgestellt, was die automatische Verarbeitung und Integration erleichtert. Proaktive Bedrohungserkennung: Unternehmen können dank der umfassenden Bedrohungsinformationen proaktive Sicherheitsstrategien entwickeln und umsetzen. Vorteile für Ihr Unternehmen Frühzeitige Bedrohungserkennung: Die Echtzeit-Updates und umfassenden Informationen ermöglichen eine schnelle Identifizierung und Abwehr potenzieller Bedrohungen. Gezielte Abwehrmaßnahmen: Durch die detaillierte Bedrohungsanalyse können Unternehmen ihre Sicherheitsmaßnahmen gezielt anpassen und verbessern. Erhöhte Cybersicherheitsresilienz: Die proaktive Überwachung und Analyse von Open-Source-Bedrohungen erhöhen die Widerstandsfähigkeit gegenüber Cyberangriffen. Effiziente Ressourcenallokation: Die präzisen Bedrohungsdaten helfen Unternehmen, ihre Sicherheitsressourcen optimal einzusetzen und gezielte Maßnahmen zu ergreifen. Compliance und Risikomanagement: Die Lösung unterstützt Unternehmen bei der Einhaltung gesetzlicher Anforderungen und bei der effektiven Verwaltung von Cyberrisiken. Integration und Nutzung **Kaspersky Threat Data Feeds - Open Source Threats** kann problemlos in bestehende Sicherheitssysteme und -infrastrukturen integriert werden. Die Bedrohungsdaten werden in maschinenlesbaren Formaten wie STIX und TAXII bereitgestellt, sodass Unternehmen sie automatisch in ihre Systeme importieren und verarbeiten können. Diese Bedrohungsfeeds sind besonders hilfreich für Unternehmen, die ihre Cybersicherheitsstrategien kontinuierlich verbessern und ihre IT-Infrastruktur proaktiv schützen möchten. Anwendungsfälle für Kaspersky Threat Data Feeds - Open Source Threats Überwachung der Open-Source-Bedrohungslandschaft: Diese Lösung ist ideal für Unternehmen, die kontinuierlich über Bedrohungen aus Open-Source-Quellen informiert bleiben möchten. Frühzeitige Identifikation von Bedrohungen: Die Bedrohungsfeeds unterstützen die schnelle Erkennung und Abwehr potenzieller Cyberbedrohungen. Unterstützung bei der Entwicklung von Sicherheitsrichtlinien: Die bereitgestellten Informationen helfen bei der Erstellung gezielter Sicherheitsrichtlinien und der Stärkung der Cybersicherheitsmaßnahmen.31987,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Data Act. Data Governance Act: DA, DGAData Act. Data Governance Act: DA, DGA , Handkommentar , Offroad-Leuchten > Zusatzbeleuchtung , Auflage: 2. Auflage, Erscheinungsjahr: 202412, Produktform: Leinen, Redaktion: Specht, Louisa~Hennemann, Moritz, Edition: NED, Auflage: 24002, Auflage/Ausgabe: 2. Auflage, Seitenzahl/Blattzahl: 1500, Keyword: Anonymisierung; DGA; DS-GVO; Datenaltruismus; Datenintermediäre; Datenrecht; Datenspenden; Datentreuhänder; Europäisches Datenrecht; Europäisches Wirtschaftsrecht; Geschäftsgeheimnisse; Weiterverwendung von Daten; Öffentliche Stellen, Fachschema: Datenschutzrecht~Europa / Europäische Union~Europäische Union - EU~Europarecht~Internationales Recht / Europarecht~International (Recht)~Internationales Recht~Menschenrechte~Jurisprudenz~Recht / Rechtswissenschaft~Rechtswissenschaft~Copyright~Geistiges Eigentum~Urheberrecht - Urheberrechtsgesetz - UrhG~Verfassungsrecht, Fachkategorie: Internationales Recht: Gewerblicher Rechtsschutz und Urheberrecht~Datenschutzrecht, Region: Deutschland~EU, Europäische Union, Warengruppe: HC/Internationales und ausländ. Recht, Fachkategorie: Schutz der Privatsphäre, Datenschutzrecht, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Nomos Verlags GmbH, Verlag: Nomos Verlags GmbH, Produktverfügbarkeit: 02, Blätteranzahl: 1456 Blätter, Länge: 207, Breite: 133, Höhe: 67, Gewicht: 1318, Produktform: Gebunden, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft,179,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Complete Guide to Open Source Big Data Stack, Fachbücher von Michael FramptonSehen Sie, wie ein auf Mesos basierender Big-Data-Stack erstellt wird und welche Komponenten verwendet werden. Sie werden derzeit verfügbare Apache-Systeme, sowohl vollständige als auch in der Inkubation befindliche, nutzen. Die Komponenten werden anhand von Beispielen vorgestellt, und Sie lernen, wie sie zusammenarbeiten. Im vollständigen Leitfaden zum Open-Source-Big-Data-Stack beginnt der Autor mit der Erstellung einer privaten Cloud und installiert und untersucht dann Apache Brooklyn. Anschliessend verwendet er jedes Kapitel, um ein Stück des Big-Data-Stacks vorzustellen, und teilt mit, wie man die Software beschafft und installiert. Sie lernen Schritt für Schritt und Kapitel für Kapitel anhand einfacher Beispiele, während ein echter Big-Data-Stack erstellt wird. Das Buch konzentriert sich auf Apache-basierte Systeme und bietet detaillierte Beispiele für Cloud-Speicher, Release-Management, Ressourcenmanagement, Verarbeitung, Warteschlangen, Frameworks, Datenvisualisierung und mehr. Was Sie lernen werden: - Installieren Sie eine private Cloud auf dem lokalen Cluster mit Apache Cloud Stack - Beschaffen, installieren und konfigurieren Sie Apache: Brooklyn, Mesos, Kafka und Zeppelin - Sehen Sie, wie Brooklyn verwendet werden kann, um Mule ESB in einem Cluster und Cassandra in der Cloud zu installieren - Installieren und verwenden Sie DCOS für die Big-Data-Verarbeitung - Verwenden Sie Apache Spark für die Datenverarbeitung im Big-Data-Stack Für wen dieses Buch gedacht ist: Entwickler, Architekten, IT-Projektmanager, Datenbankadministratoren und andere, die mit der Entwicklung oder Unterstützung eines Big-Data-Systems beauftragt sind. Es richtet sich auch an alle, die an Hadoop oder Big Data interessiert sind, sowie an diejenigen, die Probleme mit der Datengrösse haben.48,14 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was bedeutet Vorherrschaft/Hegemonie?
Vorherrschaft oder Hegemonie bezeichnet die dominante Stellung oder Kontrolle einer Gruppe, Nation oder Organisation über andere. Es beinhaltet die Fähigkeit, Entscheidungen zu treffen und Einfluss auszuüben, um die eigenen Interessen durchzusetzen und andere Akteure zu beeinflussen. Hegemonie kann auf politischer, wirtschaftlicher oder kultureller Ebene stattfinden. **
-
Was macht ein Data Scientist?
Ein Data Scientist ist für die Analyse großer Mengen von Daten verantwortlich, um wertvolle Erkenntnisse und Muster zu identifizieren. Sie entwickeln und implementieren Algorithmen und Modelle, um Prognosen und Trends vorherzusagen. Data Scientists verwenden verschiedene Programmiersprachen und Tools, um Daten zu sammeln, zu bereinigen und zu visualisieren. Sie arbeiten eng mit anderen Teams zusammen, um datengesteuerte Entscheidungen zu treffen und Geschäftsziele zu erreichen. Insgesamt ist ein Data Scientist dafür verantwortlich, Daten in verwertbare Informationen umzuwandeln und so einen Mehrwert für das Unternehmen zu schaffen. **
-
Was macht ein Data Analyst?
Ein Data Analyst sammelt, analysiert und interpretiert große Mengen von Daten, um Einblicke und Trends zu identifizieren. Sie verwenden statistische Methoden und Software, um Muster in den Daten zu erkennen und Geschäftsentscheidungen zu unterstützen. Data Analysts erstellen Berichte, Dashboards und Visualisierungen, um komplexe Informationen verständlich darzustellen. Sie arbeiten eng mit anderen Teams zusammen, um Daten zu verstehen und Empfehlungen für Verbesserungen oder Optimierungen zu geben. Insgesamt helfen Data Analysts dabei, datengesteuerte Entscheidungen zu treffen und das Geschäftswachstum voranzutreiben. **
-
Was macht ein Big Data Analyst?
Was macht ein Big Data Analyst? Ein Big Data Analyst sammelt, analysiert und interpretiert große Mengen von Daten, um wertvolle Einblicke und Muster zu gewinnen. Sie verwenden spezielle Software und Tools, um komplexe Datenmodelle zu erstellen und Trends zu identifizieren. Darüber hinaus helfen sie Unternehmen, fundierte Entscheidungen zu treffen, indem sie Prognosen und Empfehlungen auf der Grundlage ihrer Analysen bereitstellen. Ein Big Data Analyst arbeitet eng mit verschiedenen Teams zusammen, um Datenquellen zu identifizieren, Daten zu bereinigen und zu organisieren und letztendlich datengesteuerte Lösungen zu entwickeln. **
Ähnliche Suchbegriffe für Open Data
-
Was bedeuten Data Science und Data Engineering?
Data Science bezieht sich auf die Analyse und Interpretation von Daten, um Erkenntnisse und Muster zu gewinnen, die bei der Lösung von Problemen und der Unterstützung von Entscheidungsprozessen helfen. Data Engineering hingegen bezieht sich auf die Entwicklung und Verwaltung von Dateninfrastrukturen, um sicherzustellen, dass Daten effizient erfasst, gespeichert, verarbeitet und analysiert werden können. Data Engineering legt den Fokus auf die technische Seite der Datenverarbeitung, während Data Science sich auf die Analyse und Interpretation der Daten konzentriert. **
-
Was macht ein Business Intelligence Data Architect?
Ein Business Intelligence Data Architect ist für die Gestaltung und Verwaltung von Datenarchitekturen in einem Unternehmen verantwortlich. Sie analysieren die Datenbedürfnisse der Organisation, entwerfen Datenmodelle und Datenbanken, implementieren Datenintegrationsprozesse und stellen sicher, dass die Datenqualität und -integrität gewährleistet sind. Sie arbeiten eng mit anderen Fachbereichen zusammen, um sicherzustellen, dass die Dateninfrastruktur den Geschäftsanforderungen entspricht. **
-
Was sind die grundlegenden Funktionen von SPARQL und wie kann es zur Abfrage und Abfrage von verknüpften Open Data verwendet werden?
SPARQL ist eine Abfragesprache für RDF-Daten, die es ermöglicht, komplexe Abfragen über verknüpfte Datenquellen auszuführen. Die grundlegenden Funktionen von SPARQL umfassen das Abfragen von Daten, das Filtern von Ergebnissen und das Verknüpfen von verschiedenen Datenquellen. Durch die Verwendung von SPARQL können Benutzer Daten aus verschiedenen Quellen abrufen und miteinander verknüpfen, um neue Erkenntnisse zu gewinnen. **
-
Sind "data" und "data" beim USB-Kabel TX und RX?
Nein, "data" und "data" beziehen sich nicht auf die TX (Transmit) und RX (Receive) Pins beim USB-Kabel. Beim USB-Kabel gibt es vier Pins: VCC (Stromversorgung), GND (Masse), D+ (Datenleitung) und D- (Datenleitung). Die TX- und RX-Pins werden normalerweise bei seriellen Kommunikationsschnittstellen wie UART verwendet. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.